这项试验测量什么
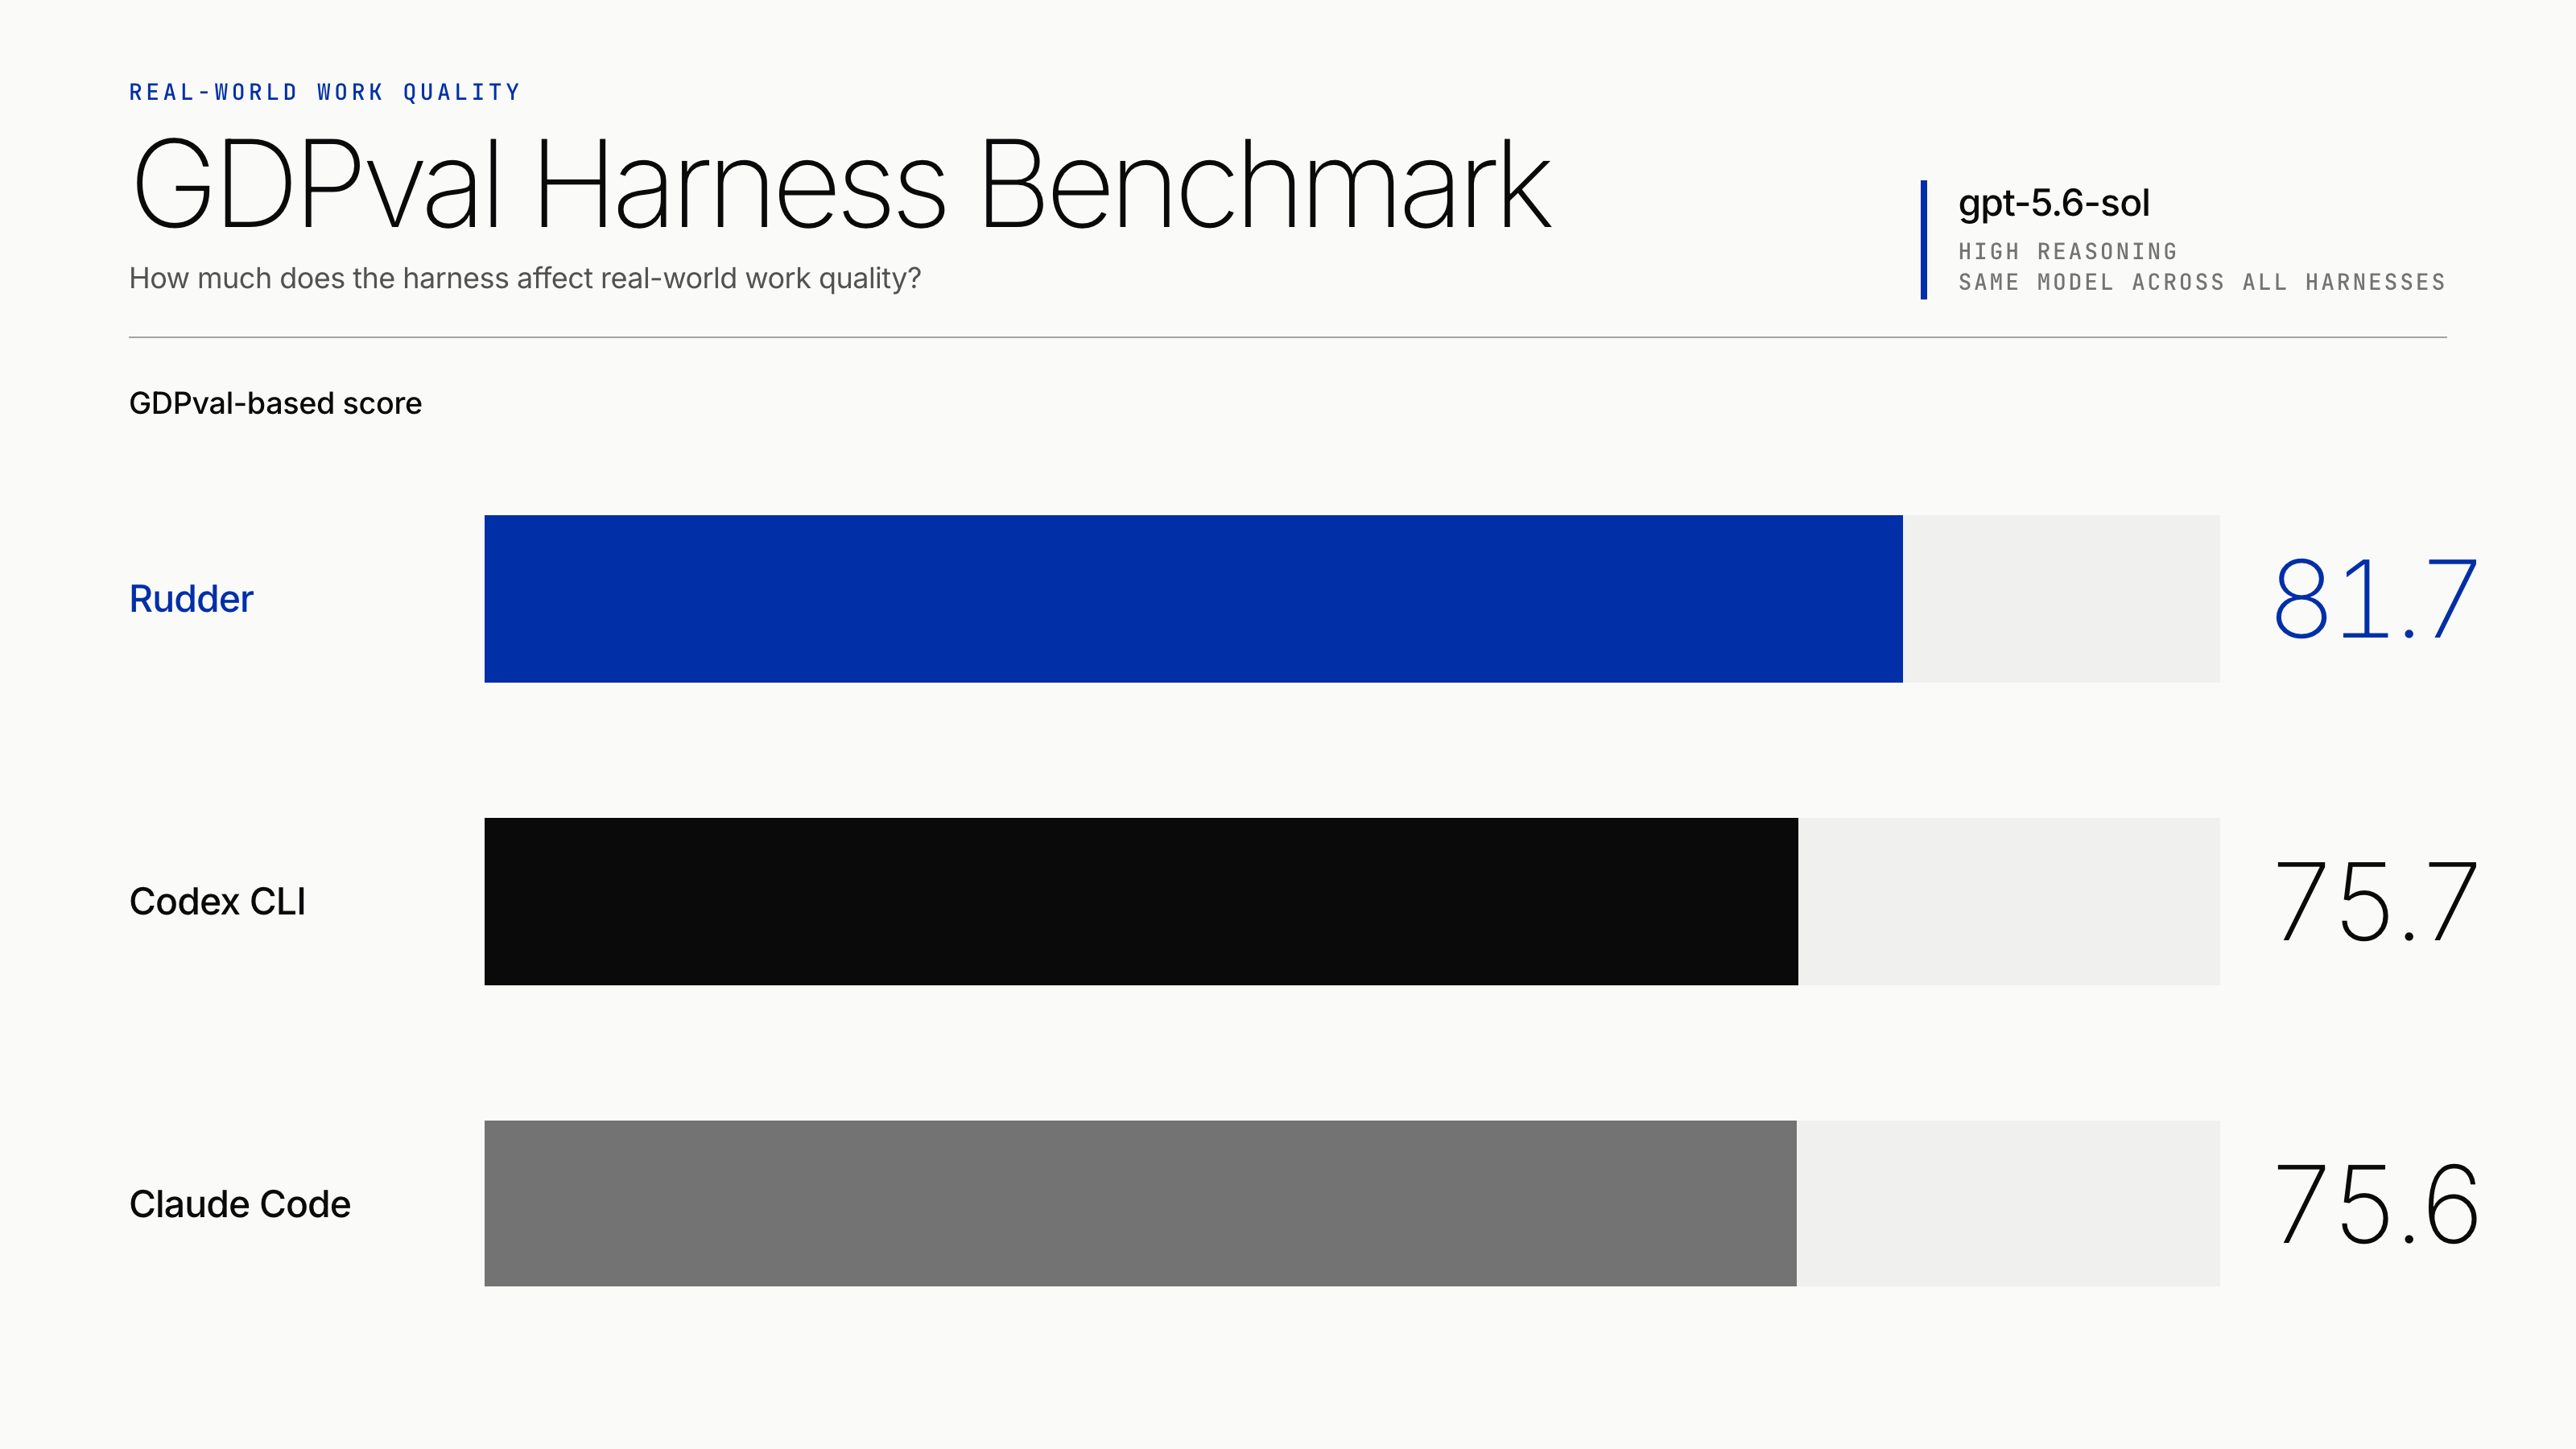
这项试验想回答一个问题:当每个环境请求相同的模型和推理强度时,执行框架 会在多大程度上影响专业任务的输出质量?比较对象是三个完整配置的系统: Rudder、Codex CLI 和 Claude Code。 每个系统都请求gpt-5.6-sol 和高推理强度。各系统原有的编排方式、会话和
工具边界仍属于试验条件,因此这不是三个相同无状态封装之间的比较。
结果概览
| 执行框架 | 本地等任务权重得分 | 有效产物 | 与标准答案对比 |
|---|---|---|---|
| Rudder | 81.7 | 10/10 | 9 胜 / 0 平 / 1 负 |
| Codex CLI | 75.7 | 10/10 | 9 胜 / 0 平 / 1 负 |
| Claude Code | 75.6 | 10/10 | 9 胜 / 0 平 / 1 负 |
冻结的比较范围
试验从 GDPval 的 220 项任务中随机抽取 10 项,并在执行前冻结样本。这组任务 覆盖 10 个职业,需要提交 11 份 XLSX、DOCX、PPTX 或 PDF 产物。每项任务总共 执行三遍:Rudder、Codex CLI 和 Claude Code 各执行一遍。因此共有 30 次评分 执行,每个“执行框架 × 任务”组合对应一次执行。 任务包来自openai/gdpval 数据集,固定版本为
11e7900cdcac61bc4daf59e65feb238acda98fbf。候选系统可以查看任务要求和源
文件,评分准则与标准答案则始终保存在独立的评分工作区。
三组执行条件
| 执行框架 | 执行条件 | 持久状态 |
|---|---|---|
| Rudder | 10 项任务依次复用同一个组织和默认托管 Agent,并使用 Rudder 的托管指令集和工具 | 托管记忆功能已启用并发生读写,但重建的时间线中有一次无法解释的连续性重置 |
| Codex CLI | 每项任务使用全新的工作区和会话 | 任务之间不复用状态 |
| Claude Code | 每项任务使用全新的工作区和会话,并通过兼容适配器路由 | 任务之间不复用状态 |
模型身份的验证证据
三组都请求了gpt-5.6-sol 和高推理强度,但各执行框架能够提供的实际模型
身份验证证据并不相同。
| 执行框架 | 可用证据 |
|---|---|
| Rudder | 10 项任务的运行元数据都与请求模型一致 |
| Claude Code | 兼容适配器的请求日志观测到 gpt-5.6-sol,包括由 Claude 别名转换的请求 |
| Codex CLI | 请求配置为 gpt-5.6-sol,但事件流没有暴露实际模型身份 |
评分方法
每个有效候选结果都由看不到执行框架标签的本地大语言模型评分器独立评分。 评分器检查源文件、候选产物、标准答案和各项评分准则,再记录逐项证据以及候选 结果与标准答案的对比结论。 所有结果都使用相同的评分器配置:gpt-5.6-sol 与高推理强度。
主要指标让每项任务的权重相同,不受 GDPval 原始评分准则分值范围不同的影响:
Local case-equal macro-normalized rubric score · 0-100,
即“本地等任务权重宏观归一化评分准则得分”。它不是完成率,产物有效性会单独
报告。
各任务结果
下表显示“获得的原始评分准则分数 / 正向最高分”。负数表示扣分项超过正向 得分;计算宏观得分时,该项任务会按零分计。| 任务 | 职业 | Claude Code | Codex CLI | Rudder | 与标准答案对比 |
|---|---|---|---|---|---|
| 审计风险指标抽样 | 会计师和审计师 | 48/63 | 49/63 | 56/63 | 全部胜 |
| 企业 UAT 计划 | 计算机和信息系统经理 | 83/101 | 74/101 | 87/101 | 全部胜 |
| 可疑活动调查 | 合规官 | 62/69 | 58/69 | 62/69 | 全部胜 |
| 物业主管绩效改进计划 | 物业和房地产经理 | 66/85 | 62/85 | 67/85 | 全部胜 |
| 自然纪录片脚本 | 影视剪辑师 | 50/51 | 51/51 | 51/51 | 全部胜 |
| BridgeMind POC 月报 | 项目管理专家 | 78/79 | 78/79 | 78/79 | 全部胜 |
| 库存事故演示文稿 | 运输和库存文员 | 74/81 | 72/81 | 76/81 | 全部胜 |
| 区域匹配报告 | 销售经理 | 61/101 | 81/101 | 80/101 | 全部胜 |
| Tiny Rod 财务报告 | 财务经理 | 62/76 | 62/76 | 62/76 | 全部负 |
| Duplex 比较市场分析 | 房地产经纪人 | -70/50 | -35/50 | 10/50 | 全部胜 |
证据边界
比较市场分析任务含有异常大的扣分项,放大了汇总差距。排除该项任务后, Rudder 仍领先约 4.4 至 4.6 个百分点。 引用结果时必须同时保留以下边界:- 每项任务总共执行三遍,三个执行框架各执行一遍。由于每个“执行框架 × 任务” 组合仍只有一次执行,因此无法估计同一执行框架内不同运行之间的方差。
- 10 项任务从全部 220 项任务中随机抽样,但样本量仍然较小,未必能代表完整 数据集。
- 评分准则分数来自本地大语言模型评分器,而不是 GDPval 的盲测专家人工评审 流程。
- 三个执行框架相对标准答案都是 9 胜 / 0 平 / 1 负。这是理解分数差距时不可 忽略的反证。
- 本次运行历史跨越设置和恢复事件,最终从保留的执行与评分记录中恢复并审计。
- Rudder 的记忆功能确实启用,但连续性并不完整,也没有进行记忆功能开关消融 试验。不能把分差归因于记忆功能。
- Codex CLI 的模型身份只验证到请求层。